Étude de cas
Nuit d'Encre
2024 → 2026
TerminéPlateforme sociale de lecture full-stack : bibliothèque personnelle, critiques, fil d'activité et gamification, portée par une API GraphQL typée de bout en bout.
01
Contexte
Nuit d'Encre est une bibliothèque sociale en ligne. Chaque lecteur tient sa bibliothèque, suit ses lectures, publie des critiques et suit d'autres lecteurs, dans une direction artistique nocturne assumée.
Le projet a démarré fin 2024. Il est déployé sur nuitdencre.fr.
02
Problème
Amener le projet au niveau production : sécurité, RGPD, tests, CI et déploiement. L'objectif : une application crédible, pas un simple CRUD.
Avec les problèmes classiques d'une API GraphQL et de ses données : requêtes N+1, calculs à centraliser, règles métier à garantir même en cas de requêtes concurrentes.
03
Ce que j'ai fait
- Recherche hybride de livres qui combine la base interne, Google Books et Open Library, avec import d'un ouvrage externe via une page de prévisualisation par ISBN et création automatique de la fiche auteur.
- Bibliothèque personnelle avec statuts de lecture, progression, notes et livres favoris, filtrable par statut, format et langue.
- Couche sociale complète : critiques (une par livre et par lecteur), commentaires, votes « utile », recommandations, abonnements entre lecteurs et fil d'activité des personnes suivies.
- Gamification : XP à chaque action, niveaux, titres débloqués par paliers, et signalement des fiches incomplètes récompensées quand un lecteur les complète.
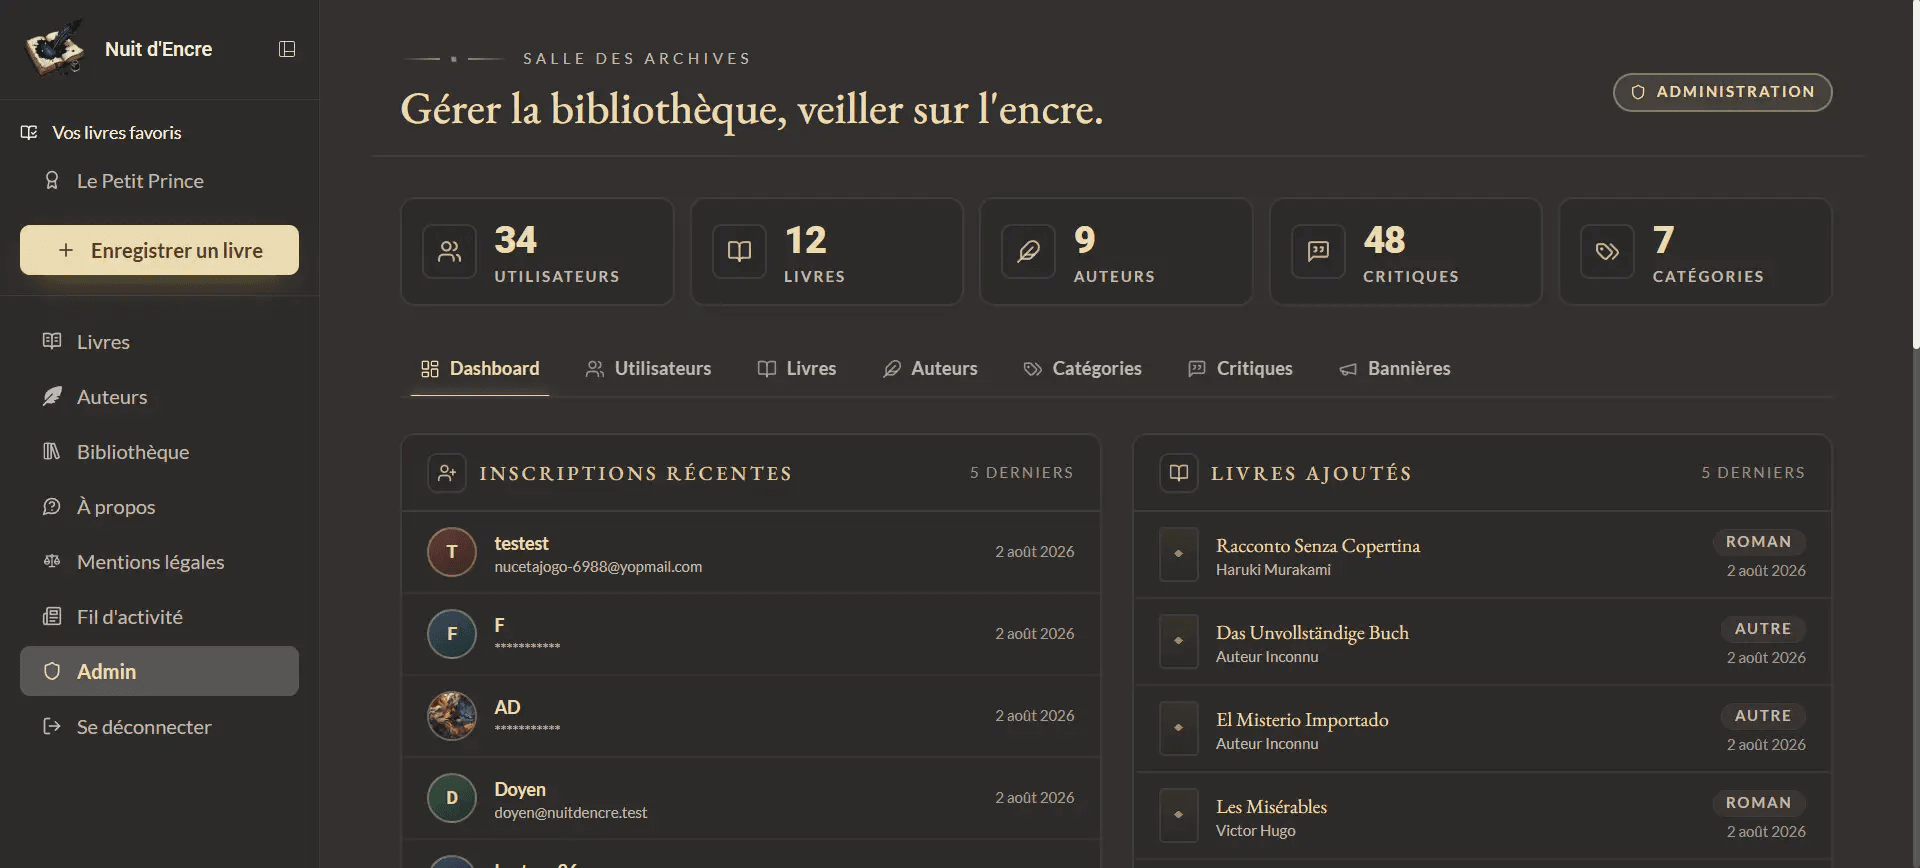
- Panel d'administration avec dashboard analytique et gestion des utilisateurs, livres, auteurs, catégories, critiques et bannières contextuelles publiées sur le site.
- Compte sécurisé et conforme RGPD : connexion par e-mail/mot de passe ou Google, réglages de confidentialité, export des données personnelles et suppression du compte.
Choix techniques
- Frontend
- SPA React 19 + Vite 5 en TypeScript 5.9 strict (noUnusedLocals/Parameters), React Router 7 avec lazy loading de toutes les pages sauf l'accueil (15 routes lazy, skeleton dédié par page) et découpage manuel du bundle en chunks vendor (react-vendor, apollo, ui-vendor, icons) pour optimiser le cache navigateur. Apollo Client 3.14 comme unique couche de données, avec une stratégie de cache hybride : cache-and-network / cache-first par défaut, network-only explicite pour les vues critiques (whoami, bannières, favoris) et refetchQueries après mutation. Logique de fetch encapsulée dans un hook par domaine, logique métier pure isolée dans lib/ (statistiques de profil, mappings de filtres, formatage). Seul état global : un AuthContext hydraté par la query WHOAMI. UI en Tailwind CSS 4 + CVA + tailwind-merge, primitives Radix UI, React Hook Form (règles de mot de passe alignées sur le backend), Motion, Sonner, react-helmet-async, auth Google via @react-oauth/google limitée aux écrans d'authentification. Polices auto-hébergées.
- Backend
- API GraphQL Apollo Server 4 + TypeGraphQL 2 (rc) : 18 resolvers organisés par domaine, 13 entités TypeORM 0.3 servant à la fois de modèle de base et de types GraphQL. Champs calculés côté serveur via FieldResolvers (note moyenne, nombre de critiques, présence en bibliothèque…) batchés par des DataLoaders instanciés par requête pour éliminer les N+1. Autorisation par @Authorized() et un customAuthChecker lisant un JWT en cookie HTTP-only signé (SameSite=Strict). Hachage Argon2, politique de mot de passe imposée aussi au changement de mot de passe, OAuth Google (google-auth-library), validation class-validator, rate limiter maison en fenêtre fixe sur login, inscription, auth Google et import de livres. Uploads Cloudinary signés côté serveur, aucune clé exposée au navigateur.
- Données & intégrations externes
- PostgreSQL 15 avec PK UUID (gen_random_uuid()), URLs de la forme /<uuid>-<slug>. Schéma versionné par migrations TypeORM (synchronize: false), rejouées au boot avec seed idempotent de l'admin et des titres de gamification. Contraintes métier garanties en base (une critique par utilisateur et par livre, unicité du nom d'auteur). Services Google Books API et Open Library interrogés en parallèle (Promise.allSettled) avec dédoublonnage par ISBN-13.
- Gamification
- Service d'attribution d'XP transactionnel : la mise à jour de l'XP et son journal d'audit (UserActions) sont écrits dans une même transaction. Chaque gain porte une clé stable (id du livre, ISBN, auteur ou couple critique/votant), et un index unique partiel PostgreSQL sur (utilisateur, type, xpKey) garantit en base qu'une action n'est créditée qu'une fois par cible. La violation d'unicité (code 23505) est interceptée pour gérer les requêtes concurrentes. Retirer puis remettre une recommandation ne rapporte donc rien, alors que recommander un autre livre crédite normalement. Niveaux dérivés du total d'XP, titres débloqués par paliers, bonus pour les critiques de plus de 200 caractères.
- Tests & qualité
- Stratégie de tests ciblée sur la logique sensible plutôt que sur une couverture exhaustive. Backend : 20 fichiers Jest couvrant l'authentification (connexion, session JWT, changement de mot de passe, OAuth Google), le contrôle d'accès GraphQL, les règles d'autorisation, l'XP (y compris la déduplication par cible), le RGPD (export et effacement), le rate limiter et les resolvers de mutations (critiques, votes, commentaires, recommandations, bibliothèque, abonnements, favoris). Ces tests appellent directement les méthodes des resolvers avec des factories (makeUser, makeContext, stubPersistence) et des statiques TypeORM mockés via jest.spyOn, sans base de données ; nombre de workers plafonné pour maîtriser la mémoire de ts-jest. Frontend : 7 fichiers Vitest sur la logique pure (agrégation et libellés du journal d'activité avec horloge figée via vi.setSystemTime, libellés de filtres envoyés au serveur, helpers d'affichage, politique de mot de passe, export JSON, liens du fil d'activité, validation de formulaire). ESLint 9 à zéro warning sur les deux workspaces, Prettier avec tri des classes Tailwind, commits conventionnels.
- Infrastructure & DevOps
- Monorepo pnpm workspace (app/frontend, app/backend). Développement sous Docker Compose (front, back, PostgreSQL 15 avec healthcheck, réseaux séparés, hot reload), proxy Vite /api. Images Node 24 Alpine, builds de production multi-stage, frontend servi par nginx-unprivileged. Production sur CapRover en trois apps : PostgreSQL, backend Node, frontend nginx servant la SPA et proxifiant /api sur le réseau interne (même origine, cookie SameSite=Strict préservé), avec un environnement de staging. CI GitHub Actions en deux jobs parallèles (lint, tests, build Vite côté front ; lint, typecheck, tests côté back) : étapes ordonnées de la moins coûteuse à la plus coûteuse, jeton en lecture seule, timeout par job, annulation des runs obsolètes. Branche master protégée par un ruleset GitHub (checks CI requis, force push interdit) : un commit n'y arrive qu'après validation sur la branche test.
04
Résultat
Une application full-stack typée de bout en bout, de la base de données au déploiement, menée sur près de deux ans. Elle est en ligne sur nuitdencre.fr.
Les problèmes classiques du GraphQL et des données sont traités à la racine : DataLoaders par requête contre les N+1, calculs centralisés côté serveur, contraintes métier garanties en base, attribution d'XP transactionnelle et idempotente.
Les tests ciblent ce qui coûte cher en cas de bug : autorisations, XP, RGPD, logique d'affichage dérivée. La logique pure est isolée pour être testée sans infrastructure lourde.
Une CI stricte, une branche protégée et une infrastructure de production documentée complètent l'ensemble.
05
Stack
- React 19
- TypeScript
- Vite
- Tailwind CSS 4
- Apollo Client
- GraphQL
- Apollo Server 4
- TypeGraphQL
- TypeORM
- PostgreSQL 15
- Vitest
- Jest
- Docker
- pnpm
- GitHub Actions
- CapRover
- nginx
- Cloudinary
07
Aperçus
Fig. 1 : Recherche de livres · Page catalogue avec recherche hybride combinant base interne, Google Books API et Open Library, avec complétion progressive des fiches importées. 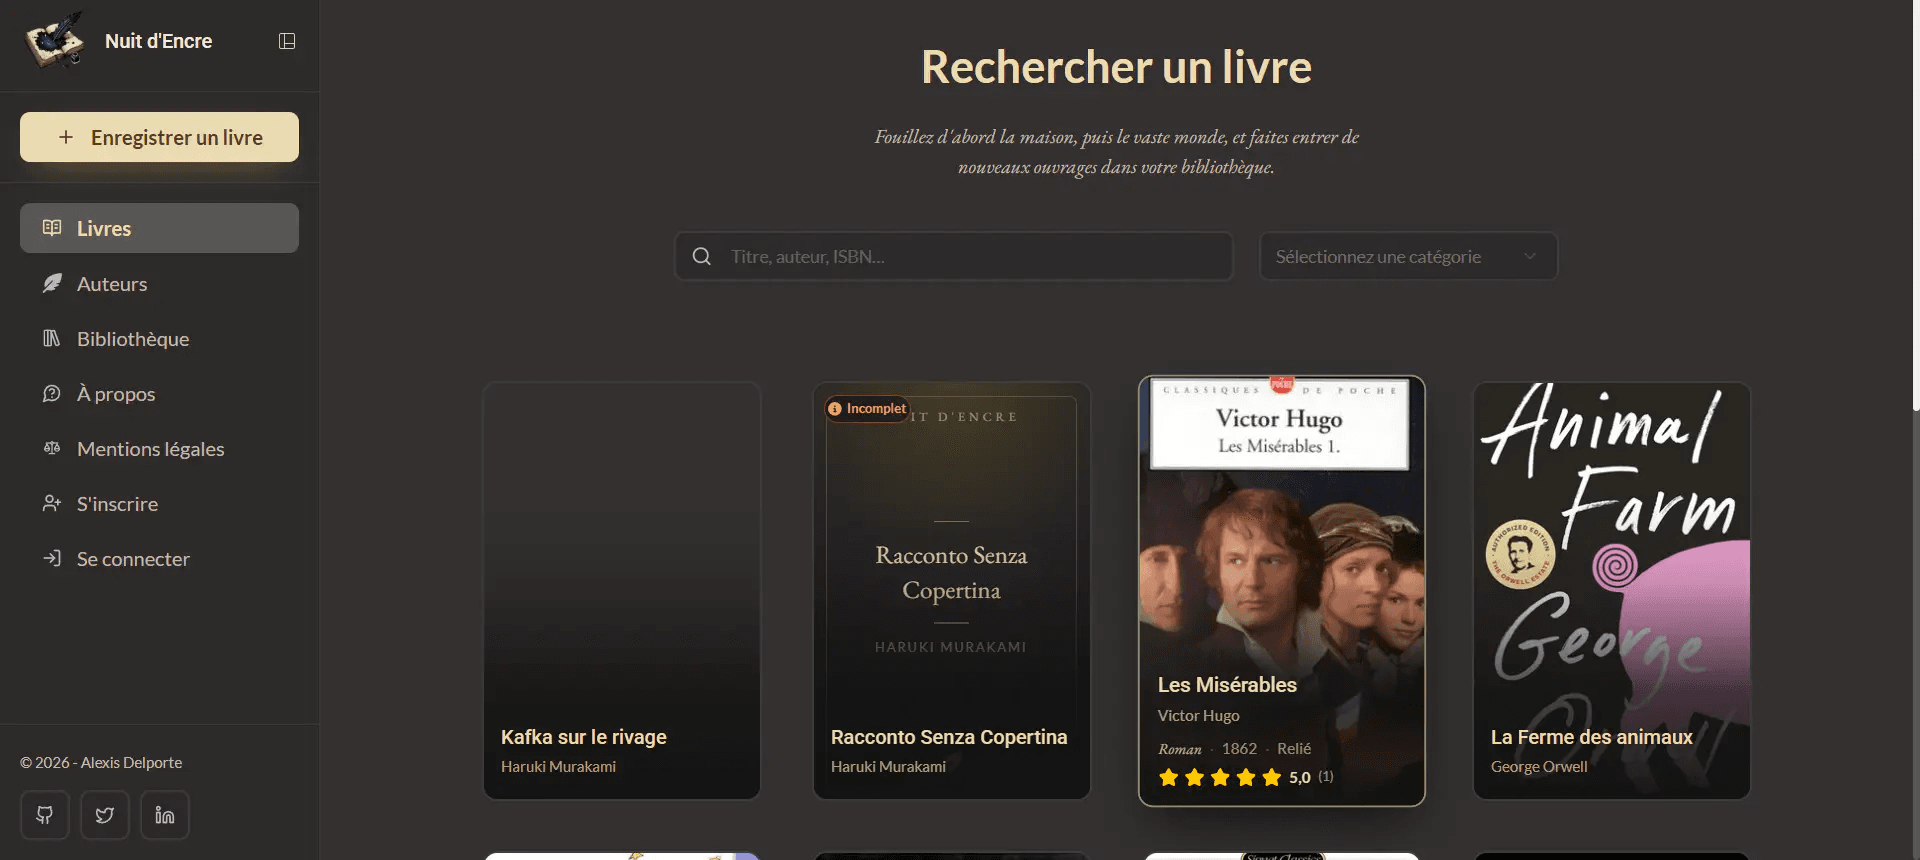
Fig. 2 : Fiche d'un livre · Détail d'un ouvrage : notes moyennes calculées côté serveur, critiques (une par utilisateur, bonus XP si détaillée), recommandations et votes. 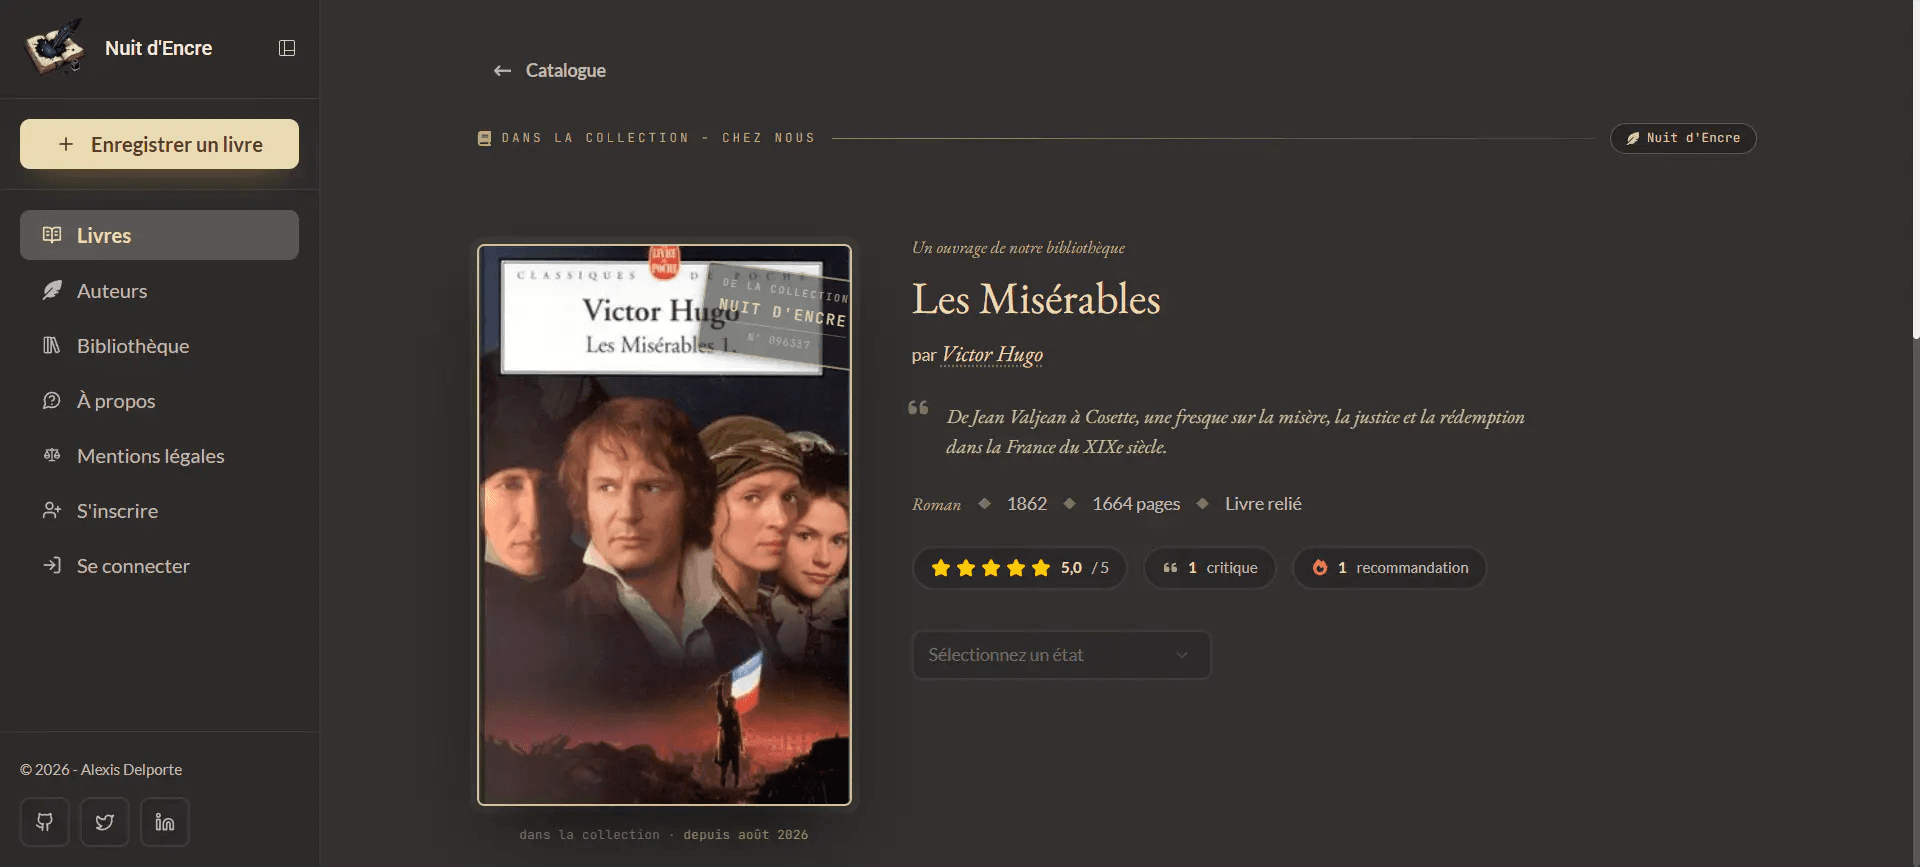
Fig. 3 : Fiche auteur · Présentation et bibliographie de l'auteur, alimentée automatiquement lors de l'import d'un livre. 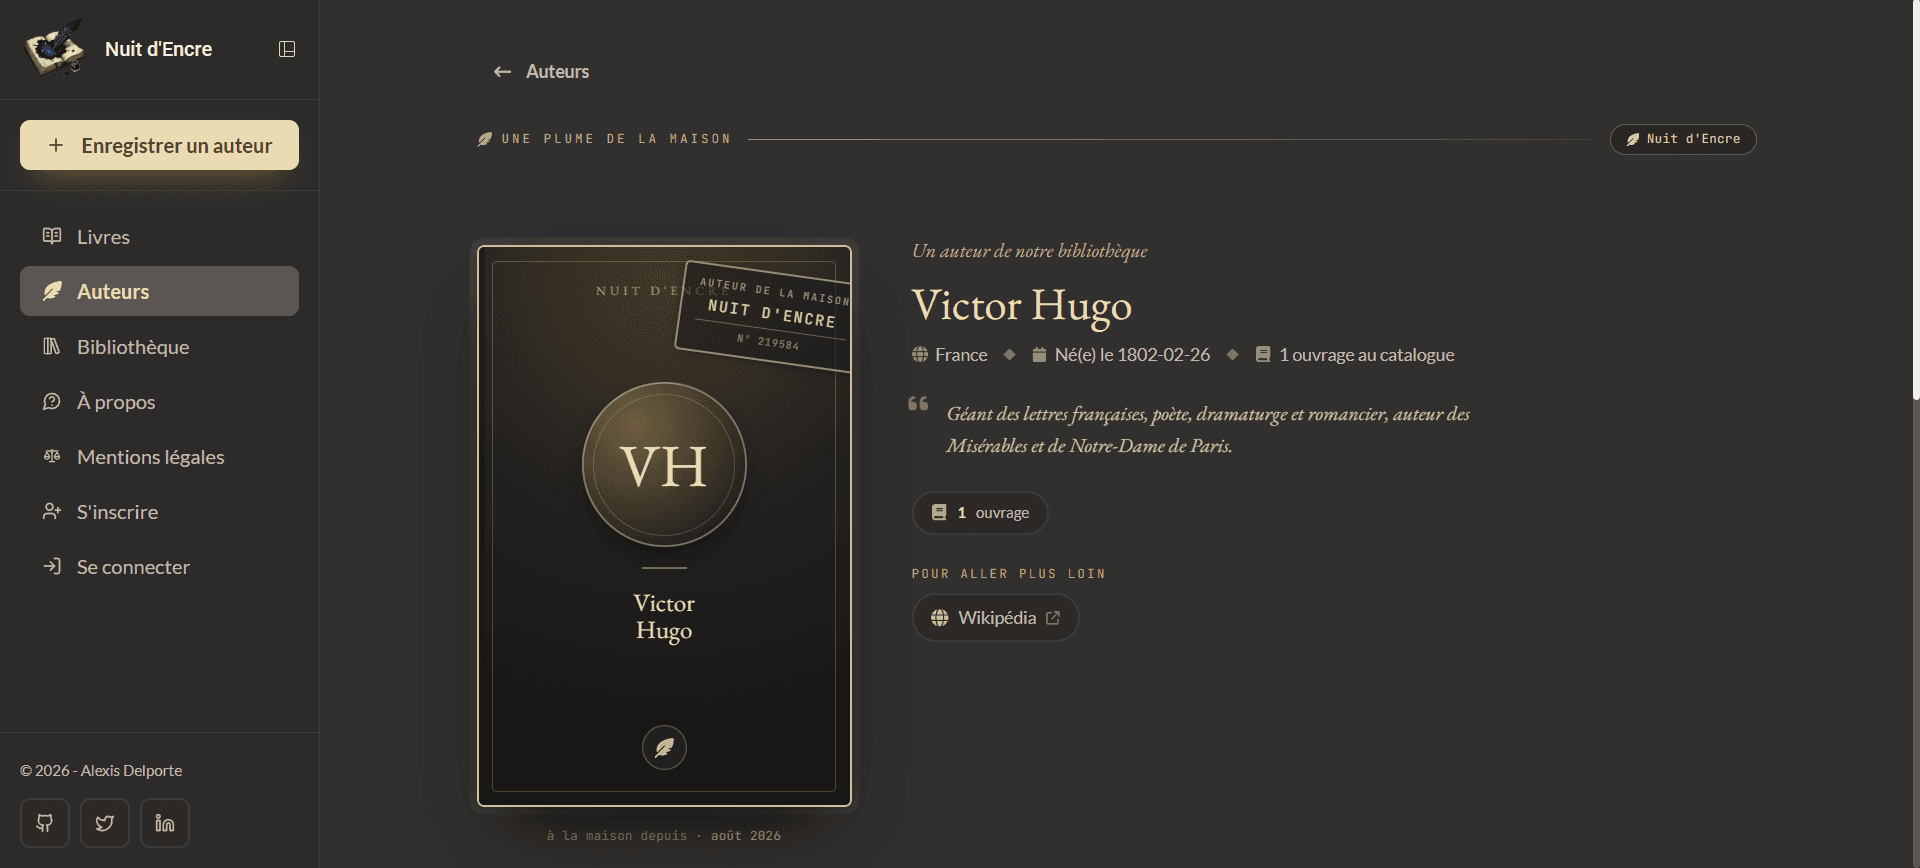
Fig. 4 : Bibliothèque personnelle · Suivi de lecture par statut ('Vos rayons'), avec filtres par format, langue et statut. 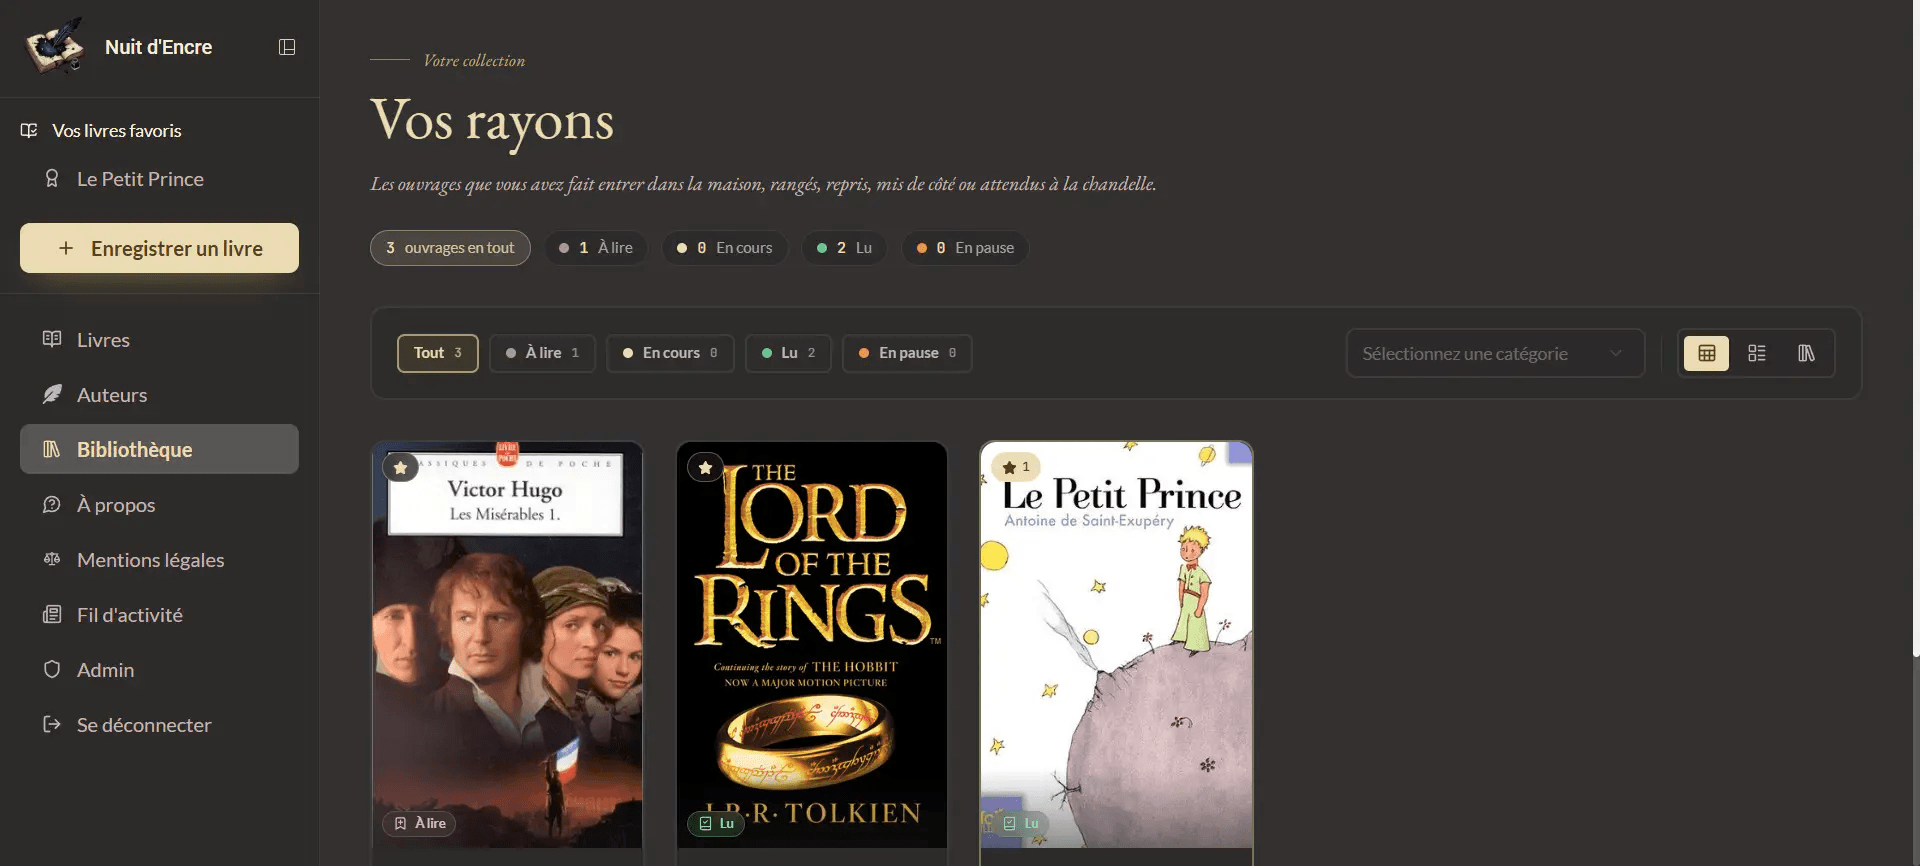
Fig. 5 : Profil utilisateur · Page profil : statistiques de lecture, progression XP, badges débloqués. 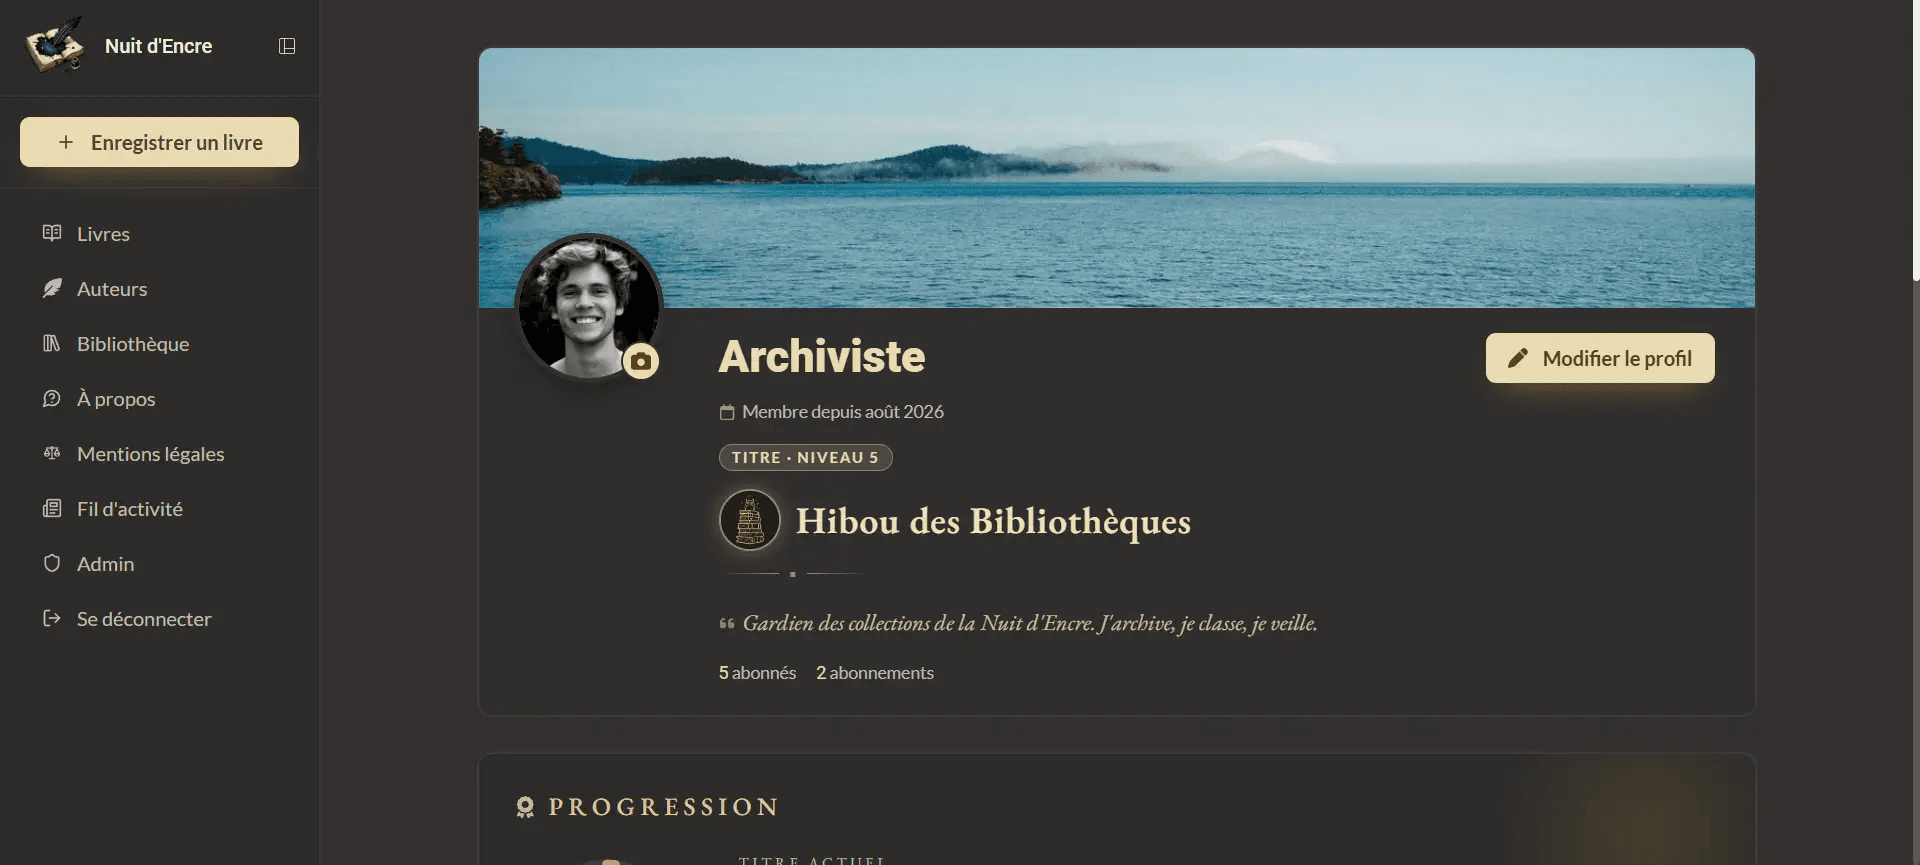
Fig. 6 : Profil utilisateur 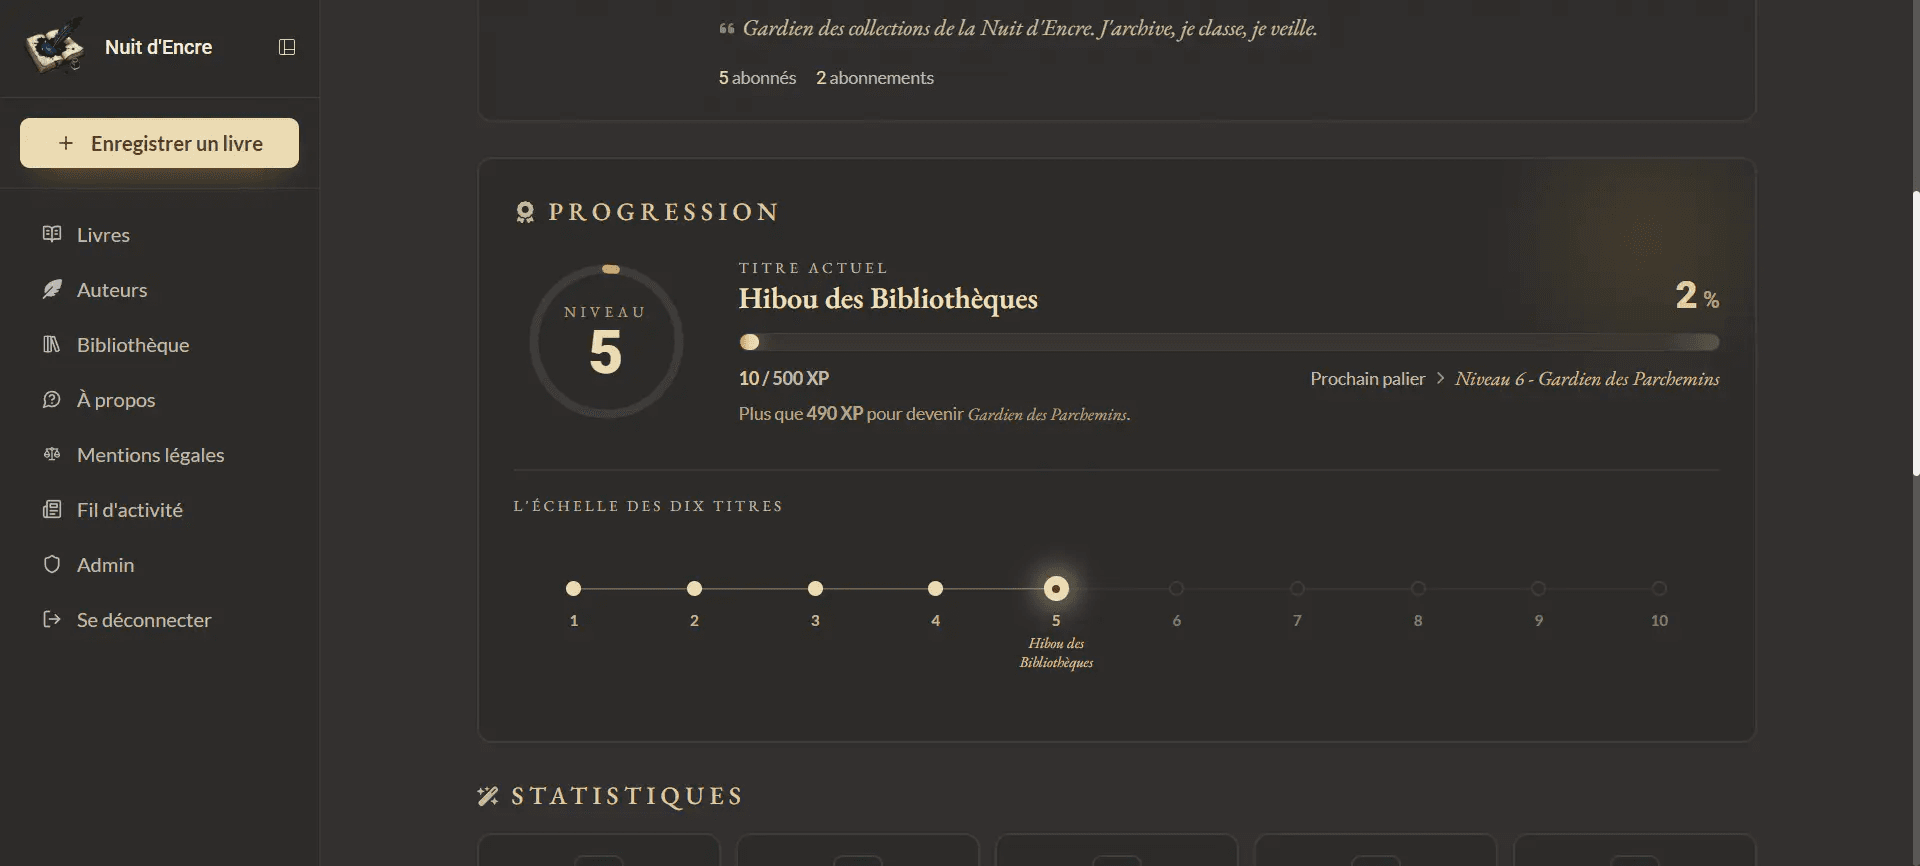
Fig. 7 : Profil utilisateur 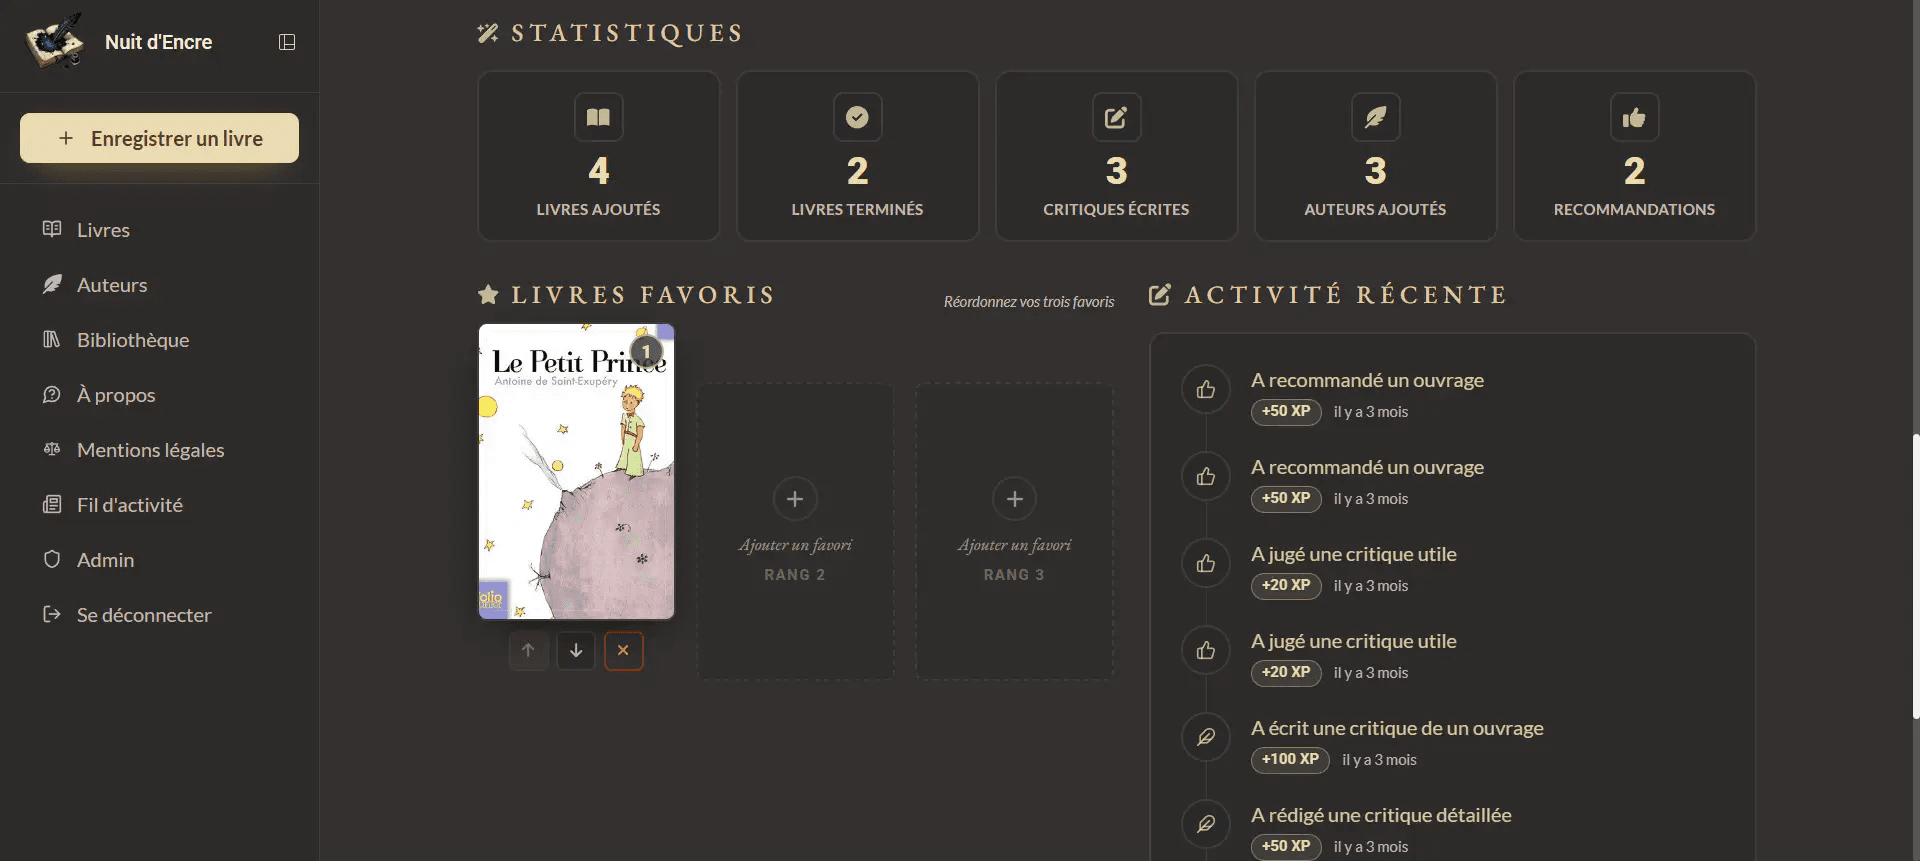
Fig. 8 : Fil d'activité social · Activité des lecteurs suivis : abonnements, critiques publiées, recommandations. 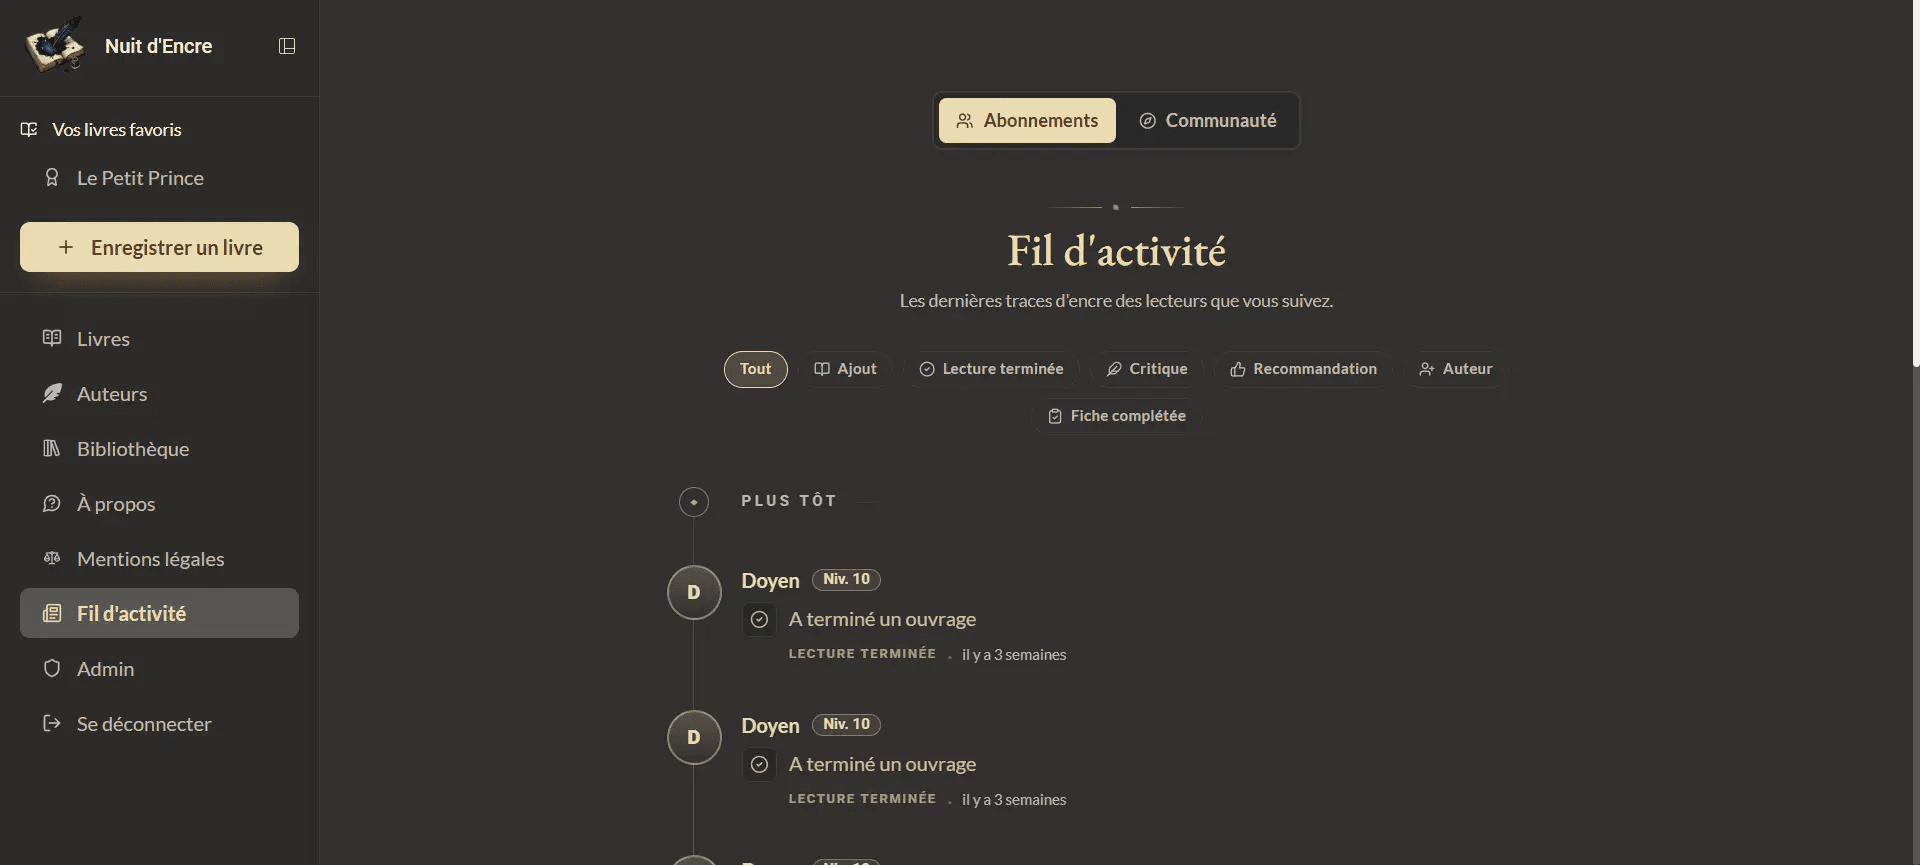
Fig. 9 : Panel admin · Back-office : 7 onglets (utilisateurs, livres, auteurs, catégories, critiques, bannières) et dashboard analytique.